封面

过去让 AI 规划旅行,经常只能得到一份“看起来很完整”的景点清单:

  • 上午去三个景点;
  • 中午随便吃饭;
  • 下午再去两个景点;
  • 晚上看夜景。

但真正出发以后,问题很快就会出现:

  • 飞机落地以后还要下机、取行李;
  • 酒店可能还不能入住,只能先寄存行李;
  • 景点名称相似,AI 可能找错地址;
  • 地图上只要二十分钟,算上叫车、等车和堵车却远远不够;
  • 博物馆有闭馆和停止入场时间;
  • 同行者体力不同,连续游览三四个小时未必现实;
  • 下雨、大风或者能见度差时,原本安排的户外景点需要调整;
  • 一旦前面延误,整天的安排就会越赶越乱。

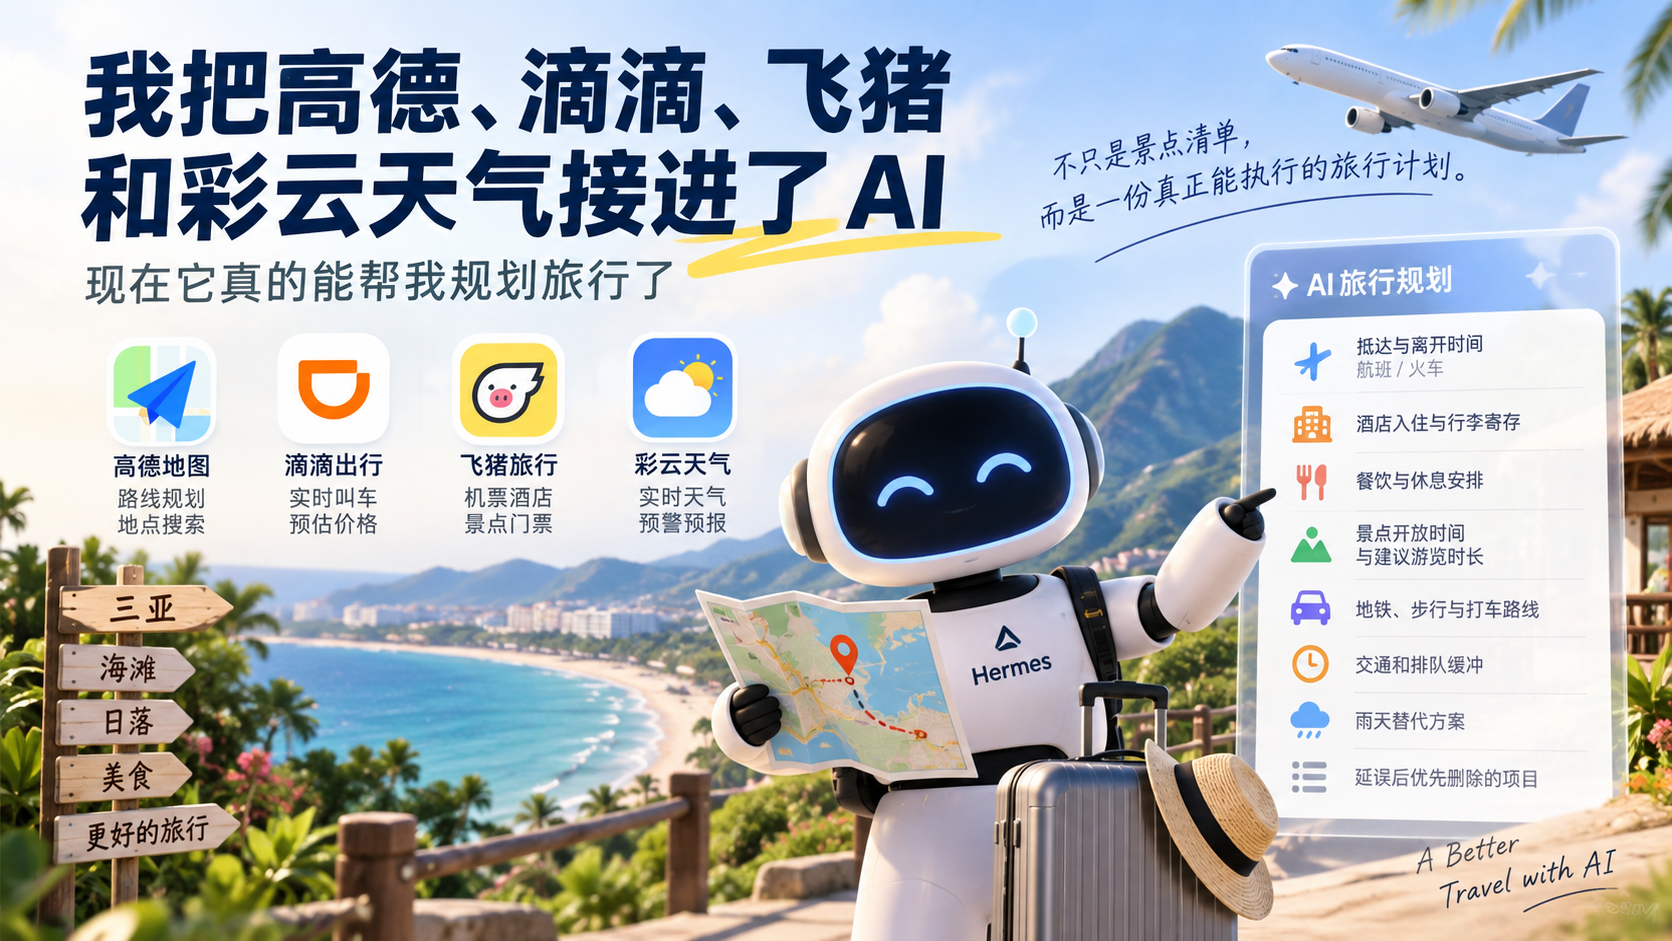
把高德地图、滴滴出行、FlyAI 和彩云天气接入 Hermes 以后,AI 才不只是“生成一份攻略”,而是可以基于实时数据,完成一套相对完整的旅行规划流程:

  1. FlyAI 查询火车、机票、酒店、景点和门票,确定跨城交通与住宿;
  2. 高德地图 确认酒店和景点的准确位置,计算景点之间的距离与路线;
  3. 滴滴出行 查询真实可用车型和当前预估价格,需要时继续叫车;
  4. 彩云天气 查询目的地天气、逐小时降雨、风力和预警;
  5. Hermes 再把这些结果组合成一份包含以下信息的可执行行程:
    • 抵达和离开时间;
    • 酒店入住、退房和行李寄存;
    • 午餐、晚餐和休息;
    • 景点开放时间和建议游览时长;
    • 地铁、步行与打车路线;
    • 交通和排队缓冲;
    • 雨天替代方案;
    • 延误后优先删除的项目。

下面用一个虚构的三亚四日游作为示例。假设游客提出的并不只是“三亚四日游”,而是:

  • 中午抵达三亚,先去酒店寄存行李或办理入住;
  • 想去南山文化旅游区、天涯海角和亚龙湾热带天堂森林公园;
  • 希望安排一次水族馆或其他室内项目,作为雨天备选;
  • 每天只安排一个主要景区,避免在最热的中午长时间步行;
  • 想留出完整的海边休息、正餐和午休时间;
  • 希望看一次日落,但不为了追景点压缩吃饭和休息。

接入这些工具后,Hermes 可以进一步判断:

  • 抵达后要为下机、取行李和前往酒店预留时间;
  • 如果酒店暂时不能入住,就先寄存行李,在附近用餐或休息;
  • 南山和天涯海角不宜与多个远距离景区硬塞在同一天;
  • 椰梦长廊更适合结合天气安排在傍晚,避开正午暴晒;
  • 水族馆可以作为降雨、大风或高温时的室内替代项目;
  • 如果航班延误,就取消抵达日的可选活动,而不是压缩晚餐和休息时间。

这才是我理解中的“AI 帮我规划旅行”:

不是把所有景点都塞进时间表,而是在真实交通、天气和体力限制下,给出一份能够执行、也允许延误的计划。

本文介绍实现这套能力所使用的四个组件:

  • amap-lbs-skill:高德地图,搜索地点、周边设施和规划路线;
  • didi-ride-skill:滴滴出行,查询打车价格、叫车和查询订单;
  • flyai:连接飞猪旅行服务,搜索火车票、机票、酒店、景点和演出;
  • 彩云天气 MCP:查询实时天气、逐小时预报、未来天气和天气预警。

需要说明的是,前三个主要以 Skill 的形式使用,彩云天气提供的是 MCP Server。对普通用户来说不必过度区分:配置完成以后,Hermes 都可以根据问题自动调用。

阅读全文 »

封面图

在不少 Prompt Engineering 教程中,经常会看到类似的技巧:

  • 「让模型只输出一个 Emoji。」
  • 「用 Emoji 代替 Yes/No,可以减少 Token。」
  • 「要求模型输出单个 Token,提高推理效率。」

这些说法听起来很合理,但实际上建立在一个错误前提之上:

认为一个 Emoji 等于一个 Token。

事实上,Token 是 Tokenizer 的产物,而 Emoji 是 Unicode 的产物,它们属于完全不同的层次。

理解这一点,需要先理清 Unicode、UTF、Emoji、Grapheme Cluster 与 Tokenizer 的关系。

阅读全文 »

封面

很多人刚接触大模型都会有一个疑问:

模型权重不是 .pt.pth 吗?为什么现在又冒出来 .safetensors.gguf.engine

为什么同一个模型,必须使用不同的组件(Transformers、vLLM、Ollama、llama.cpp)来启动?底层不都是 PyTorch 吗?

本文将从 训练 → 导出 → 推理 的完整生命周期,带你彻底理解这些问题。

阅读全文 »

概述

PageIndex是无向量模型依赖的RAG解决方案,通过推理模型将PDF或者markdown文档转换为JSON文件来实现检索

基本信息

  1. 官网地址:https://pageindex.ai
  2. GitHub地址:https://github.com/VectifyAI

适用场景

  1. 基于特定资料库的问答

注意事项

1. 部分开源

PDF/markdown转换为JSON有做开源(https://github.com/VectifyAI/PageIndex),但核心服务是闭源的,只能通过服务调用(sdk/http rest api/mcp http/mcp stdio)完成。
如果需要私有化部署需要单独联系采购

MCP没有支持文档转换

基于http的mcp不支持PDF/markdown转换为JSON。需要自己在后台页面中上传,操作较为繁琐

PDF/markdown转换为JSON效果不稳定

我上传了一份20+页的PDF,在后台看到的结果中只有2页。
因为无法直接上传我通过PageIndex生成好的json文件,只能使用云端默认的模型

评价

就我自己本身的应用场景来看,目前基于向量模型的方案没有遇到瓶颈,暂不考虑PageIndex

另外PageIndex这个服务只是作者引流的一个开源仓库,实际服务与这个开源仓库关系不大

本地依赖

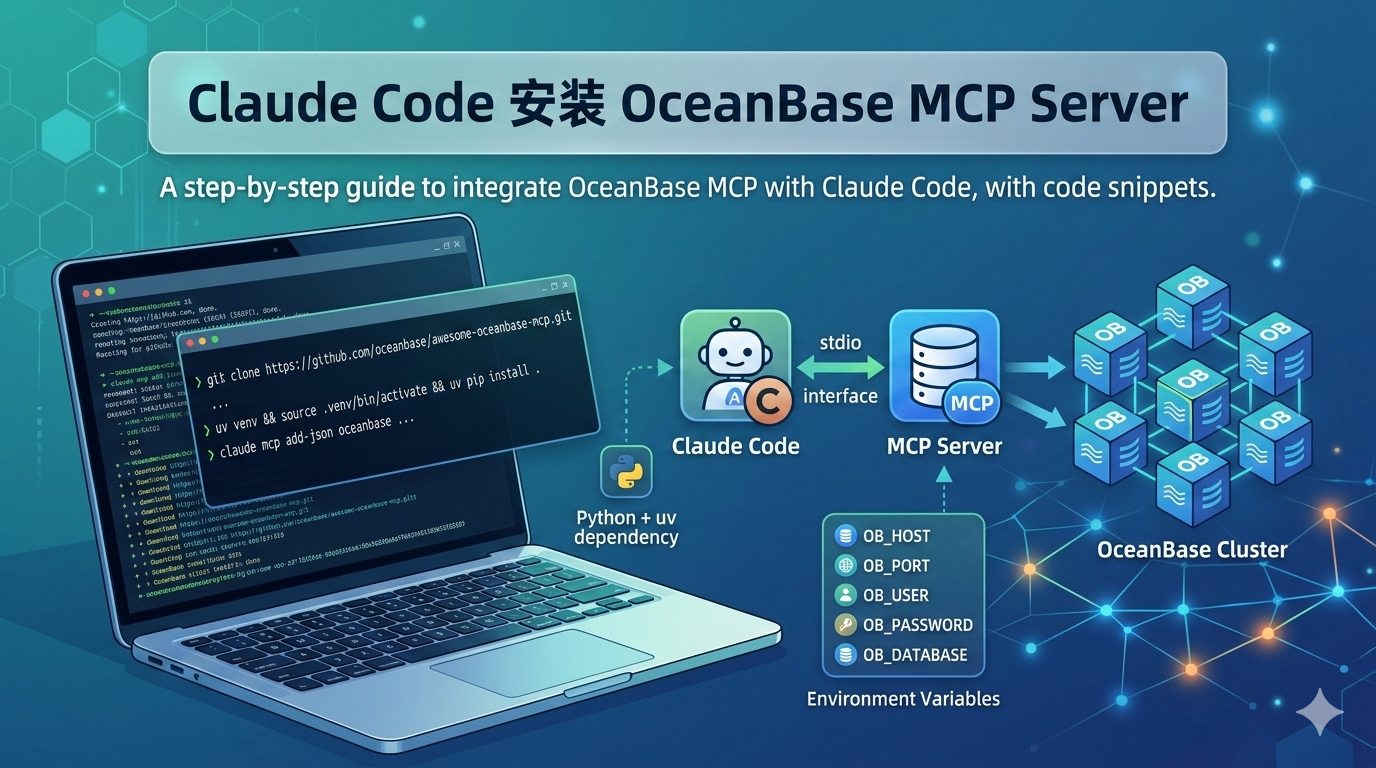
python + uv

安装步骤

  1. 从GitHub仓库中clone源码到本地
1
git clone https://github.com/oceanbase/awesome-oceanbase-mcp.git
  1. 使用uv安装python依赖
1
2
3
4
cd awesome-oceanbase-mcp && \
uv venv && \
source .venv/bin/activate && \
uv pip install .
  1. 使用claude命令添加MCP Server
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
claude mcp add-json oceanbase '{
"type":"stdio",
"command": "uv",
"args": [
"--directory",
"你的本地路径/awesome-oceanbase-mcp/src/oceanbase_mcp_server",
"run",
"oceanbase_mcp_server"
],
"env": {
"OB_HOST": "***",
"OB_PORT": "***",
"OB_USER": "***",
"OB_PASSWORD": "***",
"OB_DATABASE": "***"
}
}'

验证方法

1
claude mcp list

没有报错信息或者提示Connected即为成功

注意事项

  1. 整个仓库中不止有oceanbase数据库的mcp server,所以你在写本地路径时一定要仔细看。
  2. 如果claude报错了,你可以选择让claude自己修复
  3. 一定要有"type":"stdio"的声明

FAQ

暂无

参考资料

前提

需要安装好OpenClaw和Claude,并且配置相应的模型或者账号权限

问题集锦

1. OpenClaw一直提示需要/login

原因

我本地使用的Claude是使用litellm本地服务启动的,我有设置环境变量,是通过~/.zshrc文件维护。
OpenClaw一直报这个错,就是因为ta没有使用我的~/.zshrc文件

解决方案

告诉OpenClaw尝试先执行source ~/.zshrc再调用Claude

2. OpenClaw会因为Claude超时而失败

原因

OpenClaw在调用Claude时,不会使用Claude的交互模式,一般都是直接运行Claude -p "具体任务",而OpenClaw默认等待时间是60s左右,当你Claude超过这个时间响应时,就会导致OpenClaw因Claude超时失败

解决方案

让OpenClaw异步调用Claude,把Claude输出的日志放到一个临时文件中,然后定时轮询这个临时文件查看日志即可

感觉3月没有听到啥好听的新歌,选来选去还是把封面给王力宏的《在梅边》,后面的rap很不错。
今天才听到路虎3月发的新歌《流行歌手》,好听!

阅读全文 »
0%